看几张墨迹图,说说自己看到了什么,就能了解一个人吗?不少人对罗夏测试有这样的疑问,也怀疑它听起来像算命。其实,在心理学领域,罗夏墨迹测试诞生的 100 多年里,这种怀疑一直没有断过。
我来说说我的看法。
罗夏墨迹测试的本质
人面对陌生、奇怪的事物时,会产生各种心理活动,进而表现为外在的反应,最直观的就是语言表达。这是罗夏墨迹测试的理论基础之一,也很符合人们的直觉。
想象一下,我们在生活中如何了解朋友、同学或同事?往往是通过朝夕相处,观察对方如何说话,以及面对事情时会做出怎样的反应。
罗夏墨迹测试同样如此:它营造了一个看图说话的任务。在这个过程中,心理咨询师会观察被试者如何完成任务、如何理解图片信息,进而分析其心理状态。
一句话能分析出什么?
我在给一位女士施测时,她看到第 6、7、9 张图后感叹:“这个图也太抽象了吧?!”“天呐,怎么又是一幅抽象的图片?!”这是测试中一个很细微的点。类似的细微特征可以被记录和综合分析,成为测试系统的线索。
什么心理状态可能让她说出这些话?她或许觉得任务有些难,感到压力;也可能对测试有疑问、质疑或抵触,看过多张图片后已经感到厌烦。当然,这些都只是有待结合完整测试过程进一步核实的可能性,不能凭一句话直接下结论。
在我看来,这样的细节可能提供心理状态的蛛丝马迹;而一次测试中,值得综合观察的细微特征有很多。
历史上,人们到底在质疑什么?
罗夏测试给人的表达空间很大。丰富的回答能提供值得探索的线索,也让记录、编码和解释变得困难。如果分析规则不清楚,或者解释超出了证据,结果就可能失准。
2013 年,心理学研究者对罗夏综合体系中的 65 个主要变量进行了系统综述和元分析:一些变量获得了较好的研究支持,一些支持较弱,还有一些缺少足够研究。
这引出了几个问题:哪些特征有效,能否稳定测量?在什么人群、族群和用途下有证据支持?不同心理咨询师面对同一份测试资料,是否会得出不同结论?我把这些问题概括为特征、数据和模型三个方面。
过去,计算机技术不够发达,许多研究者主要依靠人工施测、统计和编码,分析阶段也较依赖个人经验。各环节都可能引入不确定性,从而影响结果的一致性。
AI 与罗夏墨迹结合起来
尽管过去人工成本高、信息处理容易产生差异,罗夏测试所尝试观察的内容仍值得研究。2022 年以来,ChatGPT 等大语言模型展示了很强的自然语言处理能力。作为 AI 算法工程师,我希望尝试利用数据和模型,研究测试中的多种特征与心理维度之间的关系。
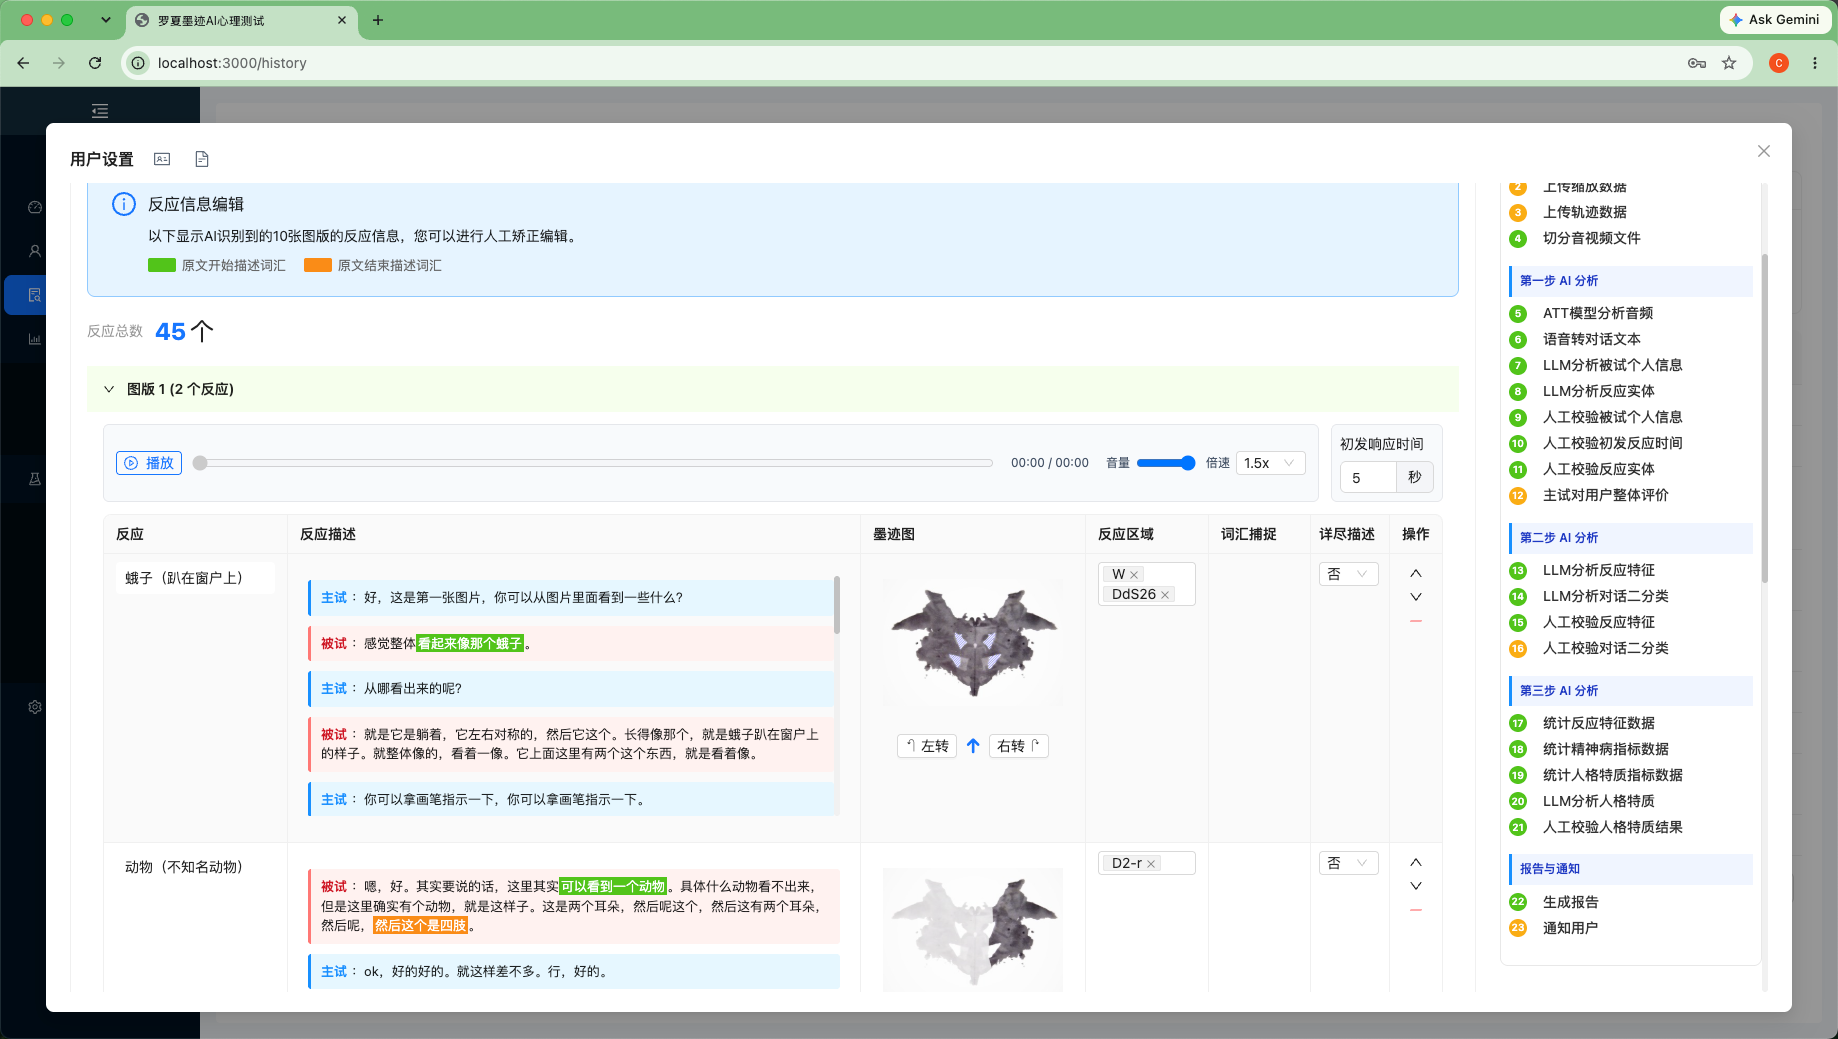 塞拉罗夏测试的信息整理与分析界面
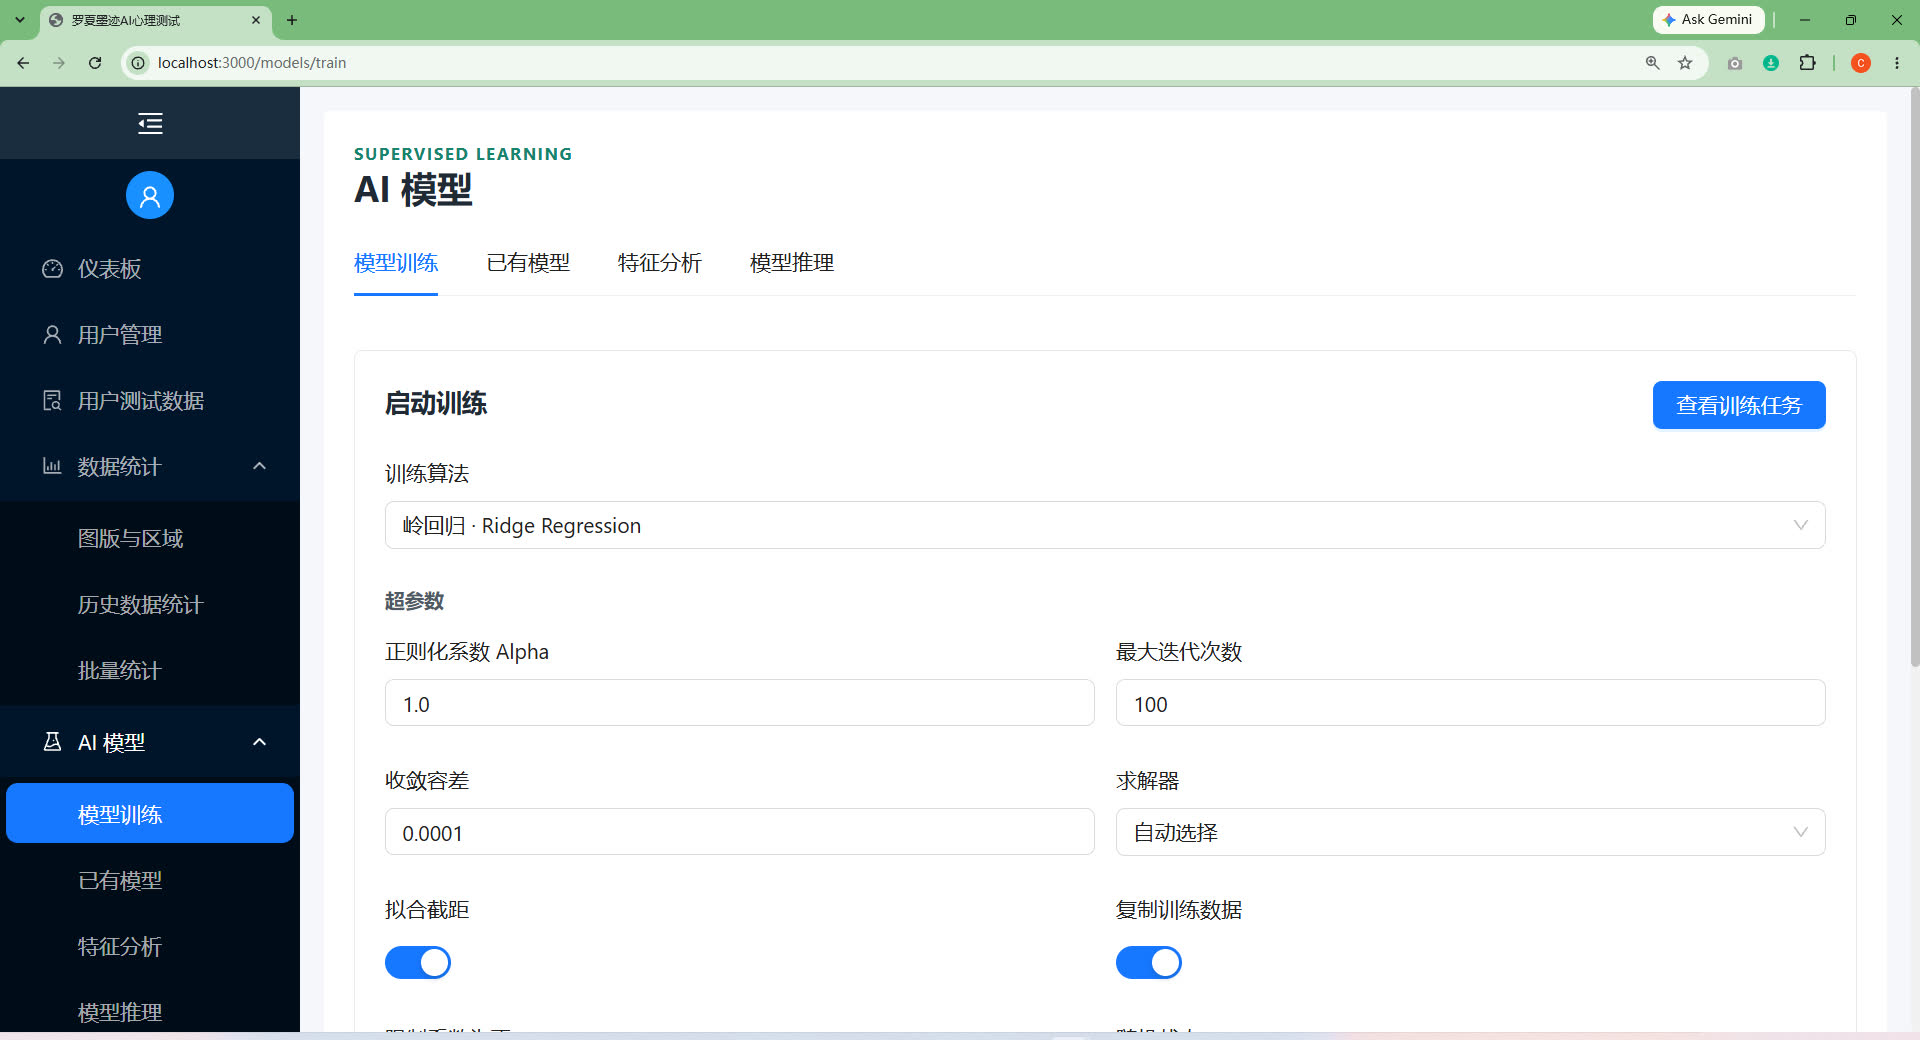 塞拉罗夏心理测试系统的 AI 模型训练界面
我正在开发的塞拉罗夏墨迹心理测试系统,利用大语言模型辅助规范化采集和整理测试数据,将其转化为标准特征并建立特征库,同时训练 AI 模型,尝试拟合这些特征与人格维度之间的关系。
更多高质量数据能够帮助我们检验解释。随着用户参与和资料积累,我希望不断优化模型,研究它在不同人群中的表现,并通过独立验证检查效度。数据增加本身并不能保证结果更准确,模型的实际效果仍需要检验。
对我来说,最重要的不是证明罗夏能解释一切,而是保留有依据的部分,认真检验有争议的部分,让每一次判断都更容易追溯和修正。这就是我最近两年利用 AI 在罗夏墨迹测试上所做的工作。